AI / WALIDACJA MODELU
Walidacja modelu
Trafność przewidywań oceniamy z dwóch perspektyw: na danych nieznanych modelowi oraz w odniesieniu do wyników eksperymentów.
- Dane do uczenia modelu
- ChEMBL 23Wersja z 2017 roku
- Dane do walidacji
- Do wersji ChEMBL 33Oddziaływania nieznane modelowi
- Zbiór testowy
- Około 100 tys.Par lek–cel białkowy
Walidacja na nowych danych
Aby ocenić trafność przewidywań, ponownie dopasowaliśmy parametry modelu, korzystając z historycznych danych ChEMBL 23. Następnie przewidzieliśmy oddziaływania lek–cel białkowy dodane do bazy później, do wersji ChEMBL 33 włącznie. Te dane nie były dostępne podczas uczenia modelu. Taki podział według czasu pozwala sprawdzić przewidywania na nowych danych.
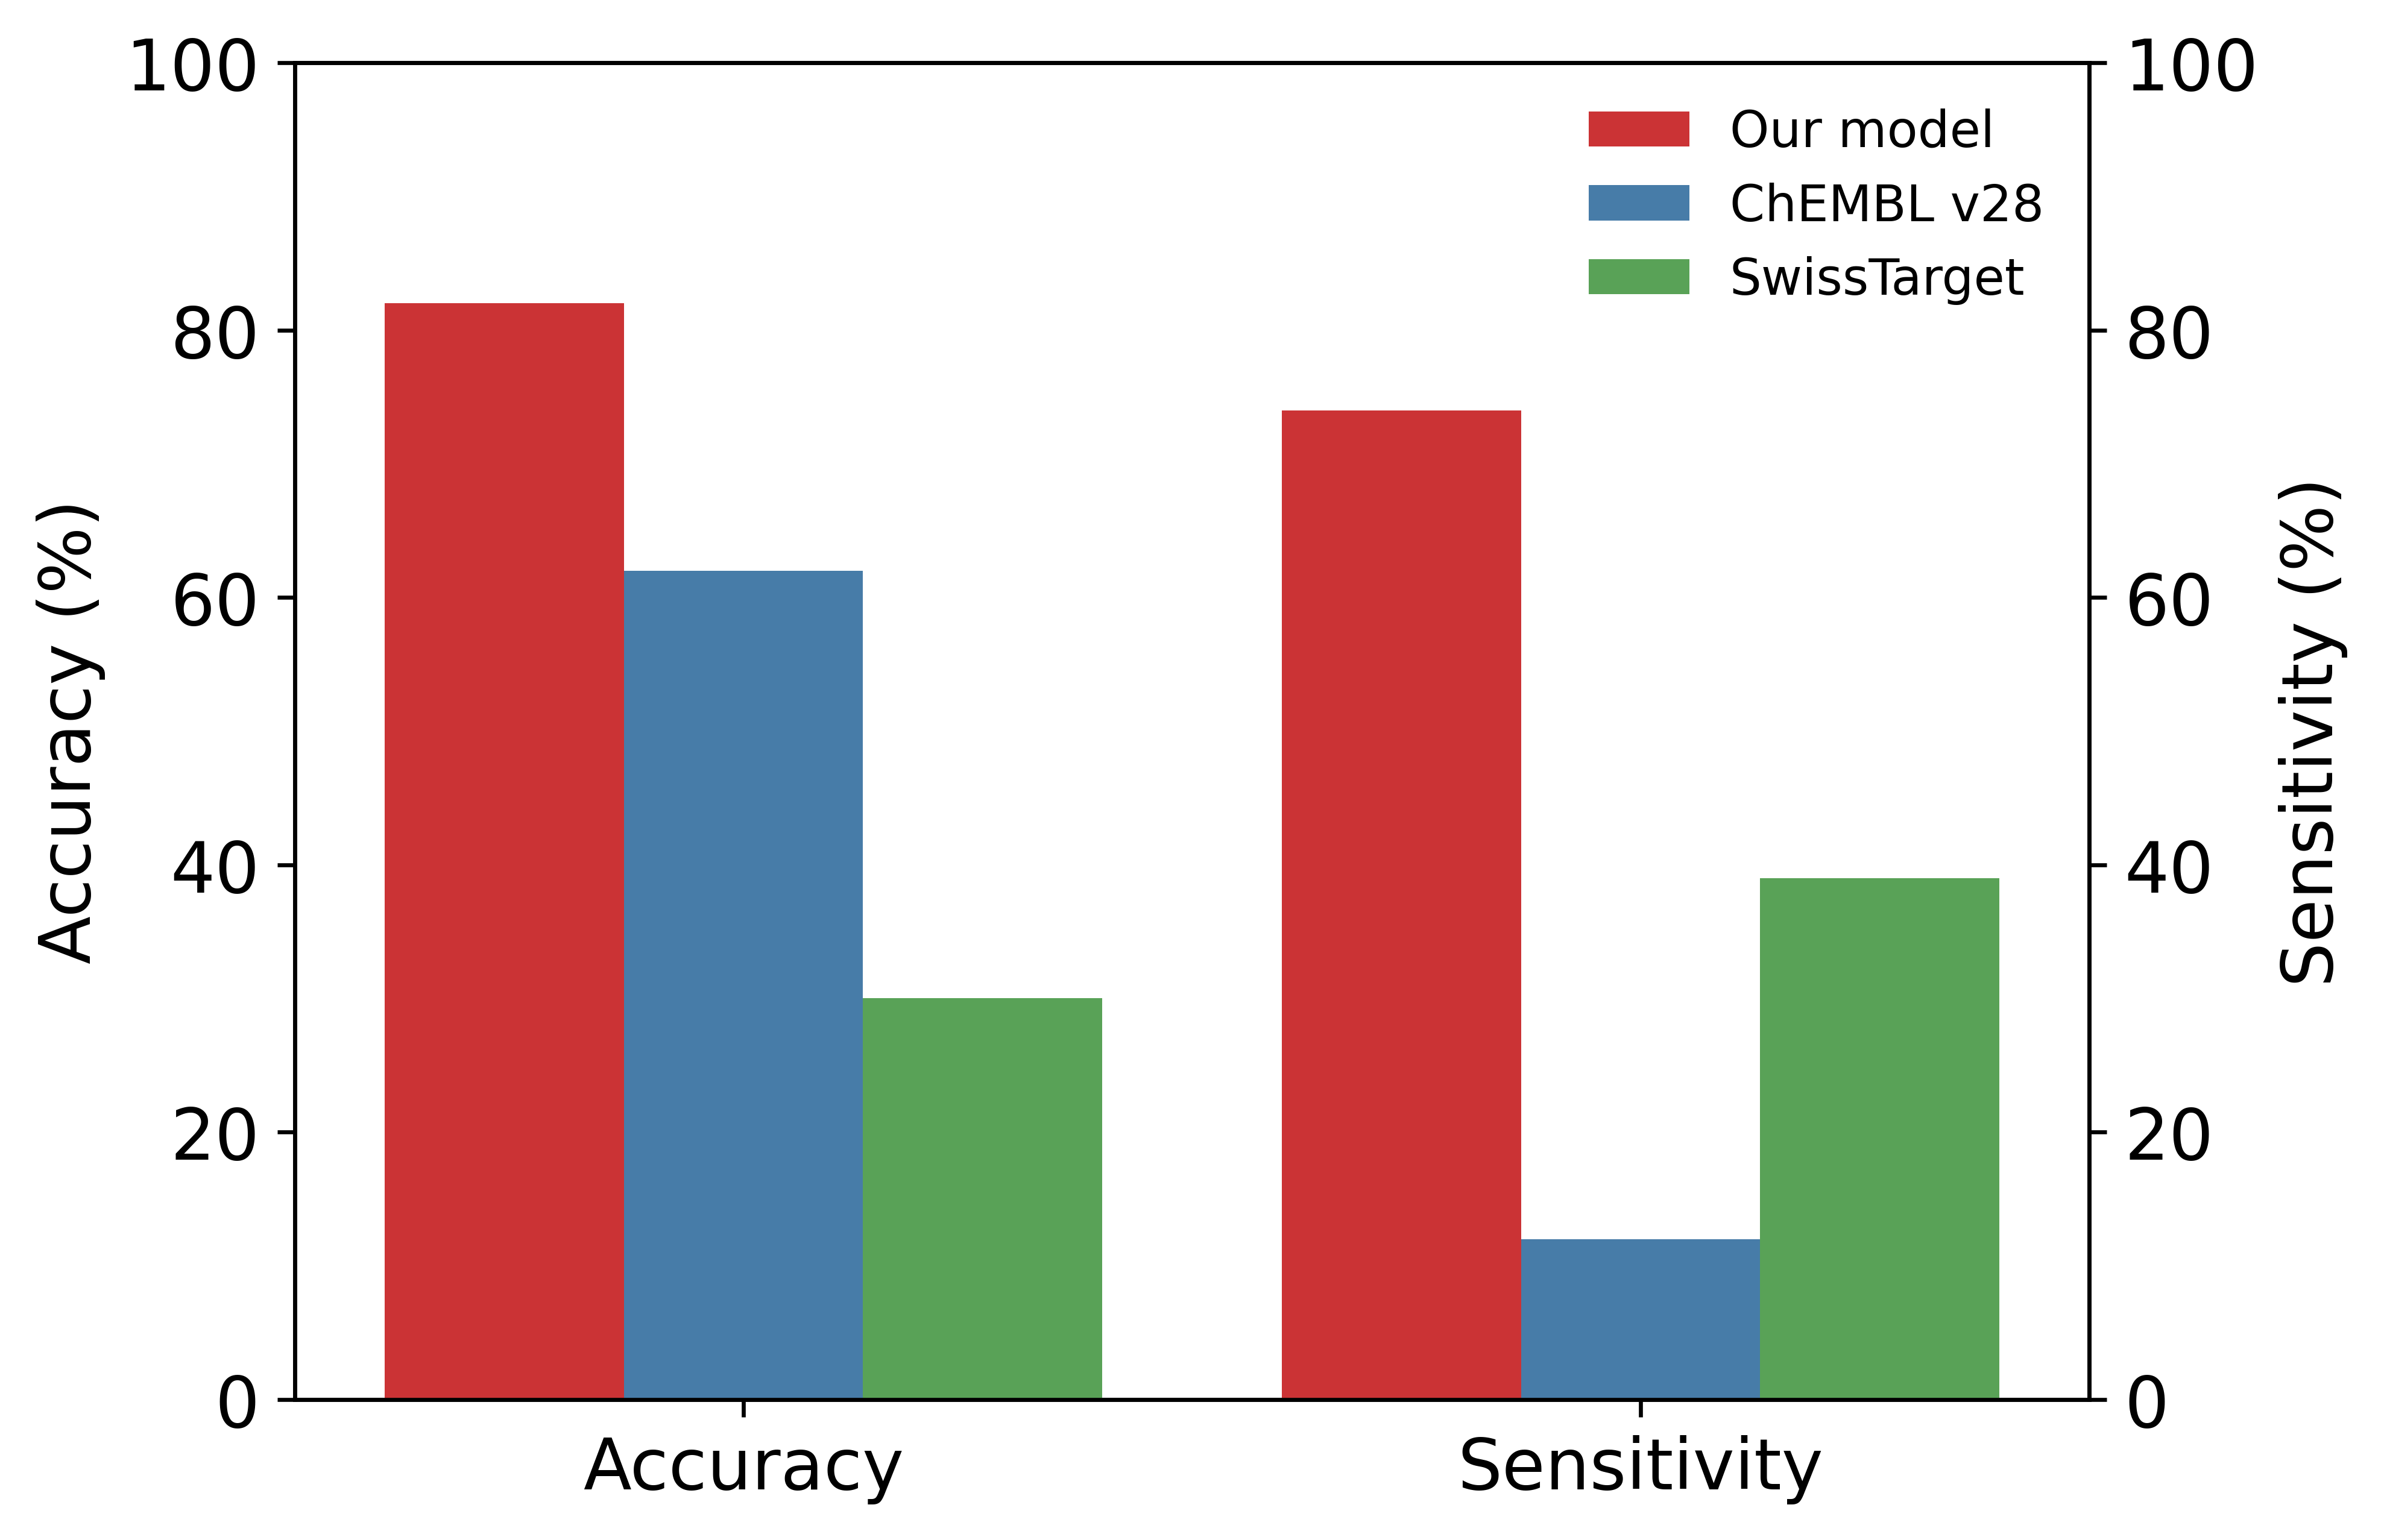 Trafność klasyfikacji i wykrywanie aktywnych związków
Jak rozumieć przedstawione miary
Trafność klasyfikacji (Accuracy)
Odsetek par ligand–cel białkowy prawidłowo zaklasyfikowanych jako aktywne lub nieaktywne.
Wykrywanie aktywnych związków (Sensitivity)
W tym porównaniu: prawdopodobieństwo znalezienia znanego aktywnego związku wśród 20 najwyżej ocenionych kandydatów, uśrednione po celach białkowych. Jest to definicja przyjęta w tym badaniu, a nie standardowa miara czułości klasyfikatora.
ODNIESIENIE DO EKSPERYMENTU
Porównanie z badaniami in vitro
Wyniki eksperymentów nie są idealnie powtarzalne. W tym historycznym porównaniu wykorzystano 20 par niezależnych testów wybranych z literatury, dotyczących tego samego celu lub efektu biologicznego. Dla związków zbadanych w obu testach wynik jednego stanowił punkt odniesienia dla drugiego. Względem tego samego punktu odniesienia oceniono przewidywania modelu.
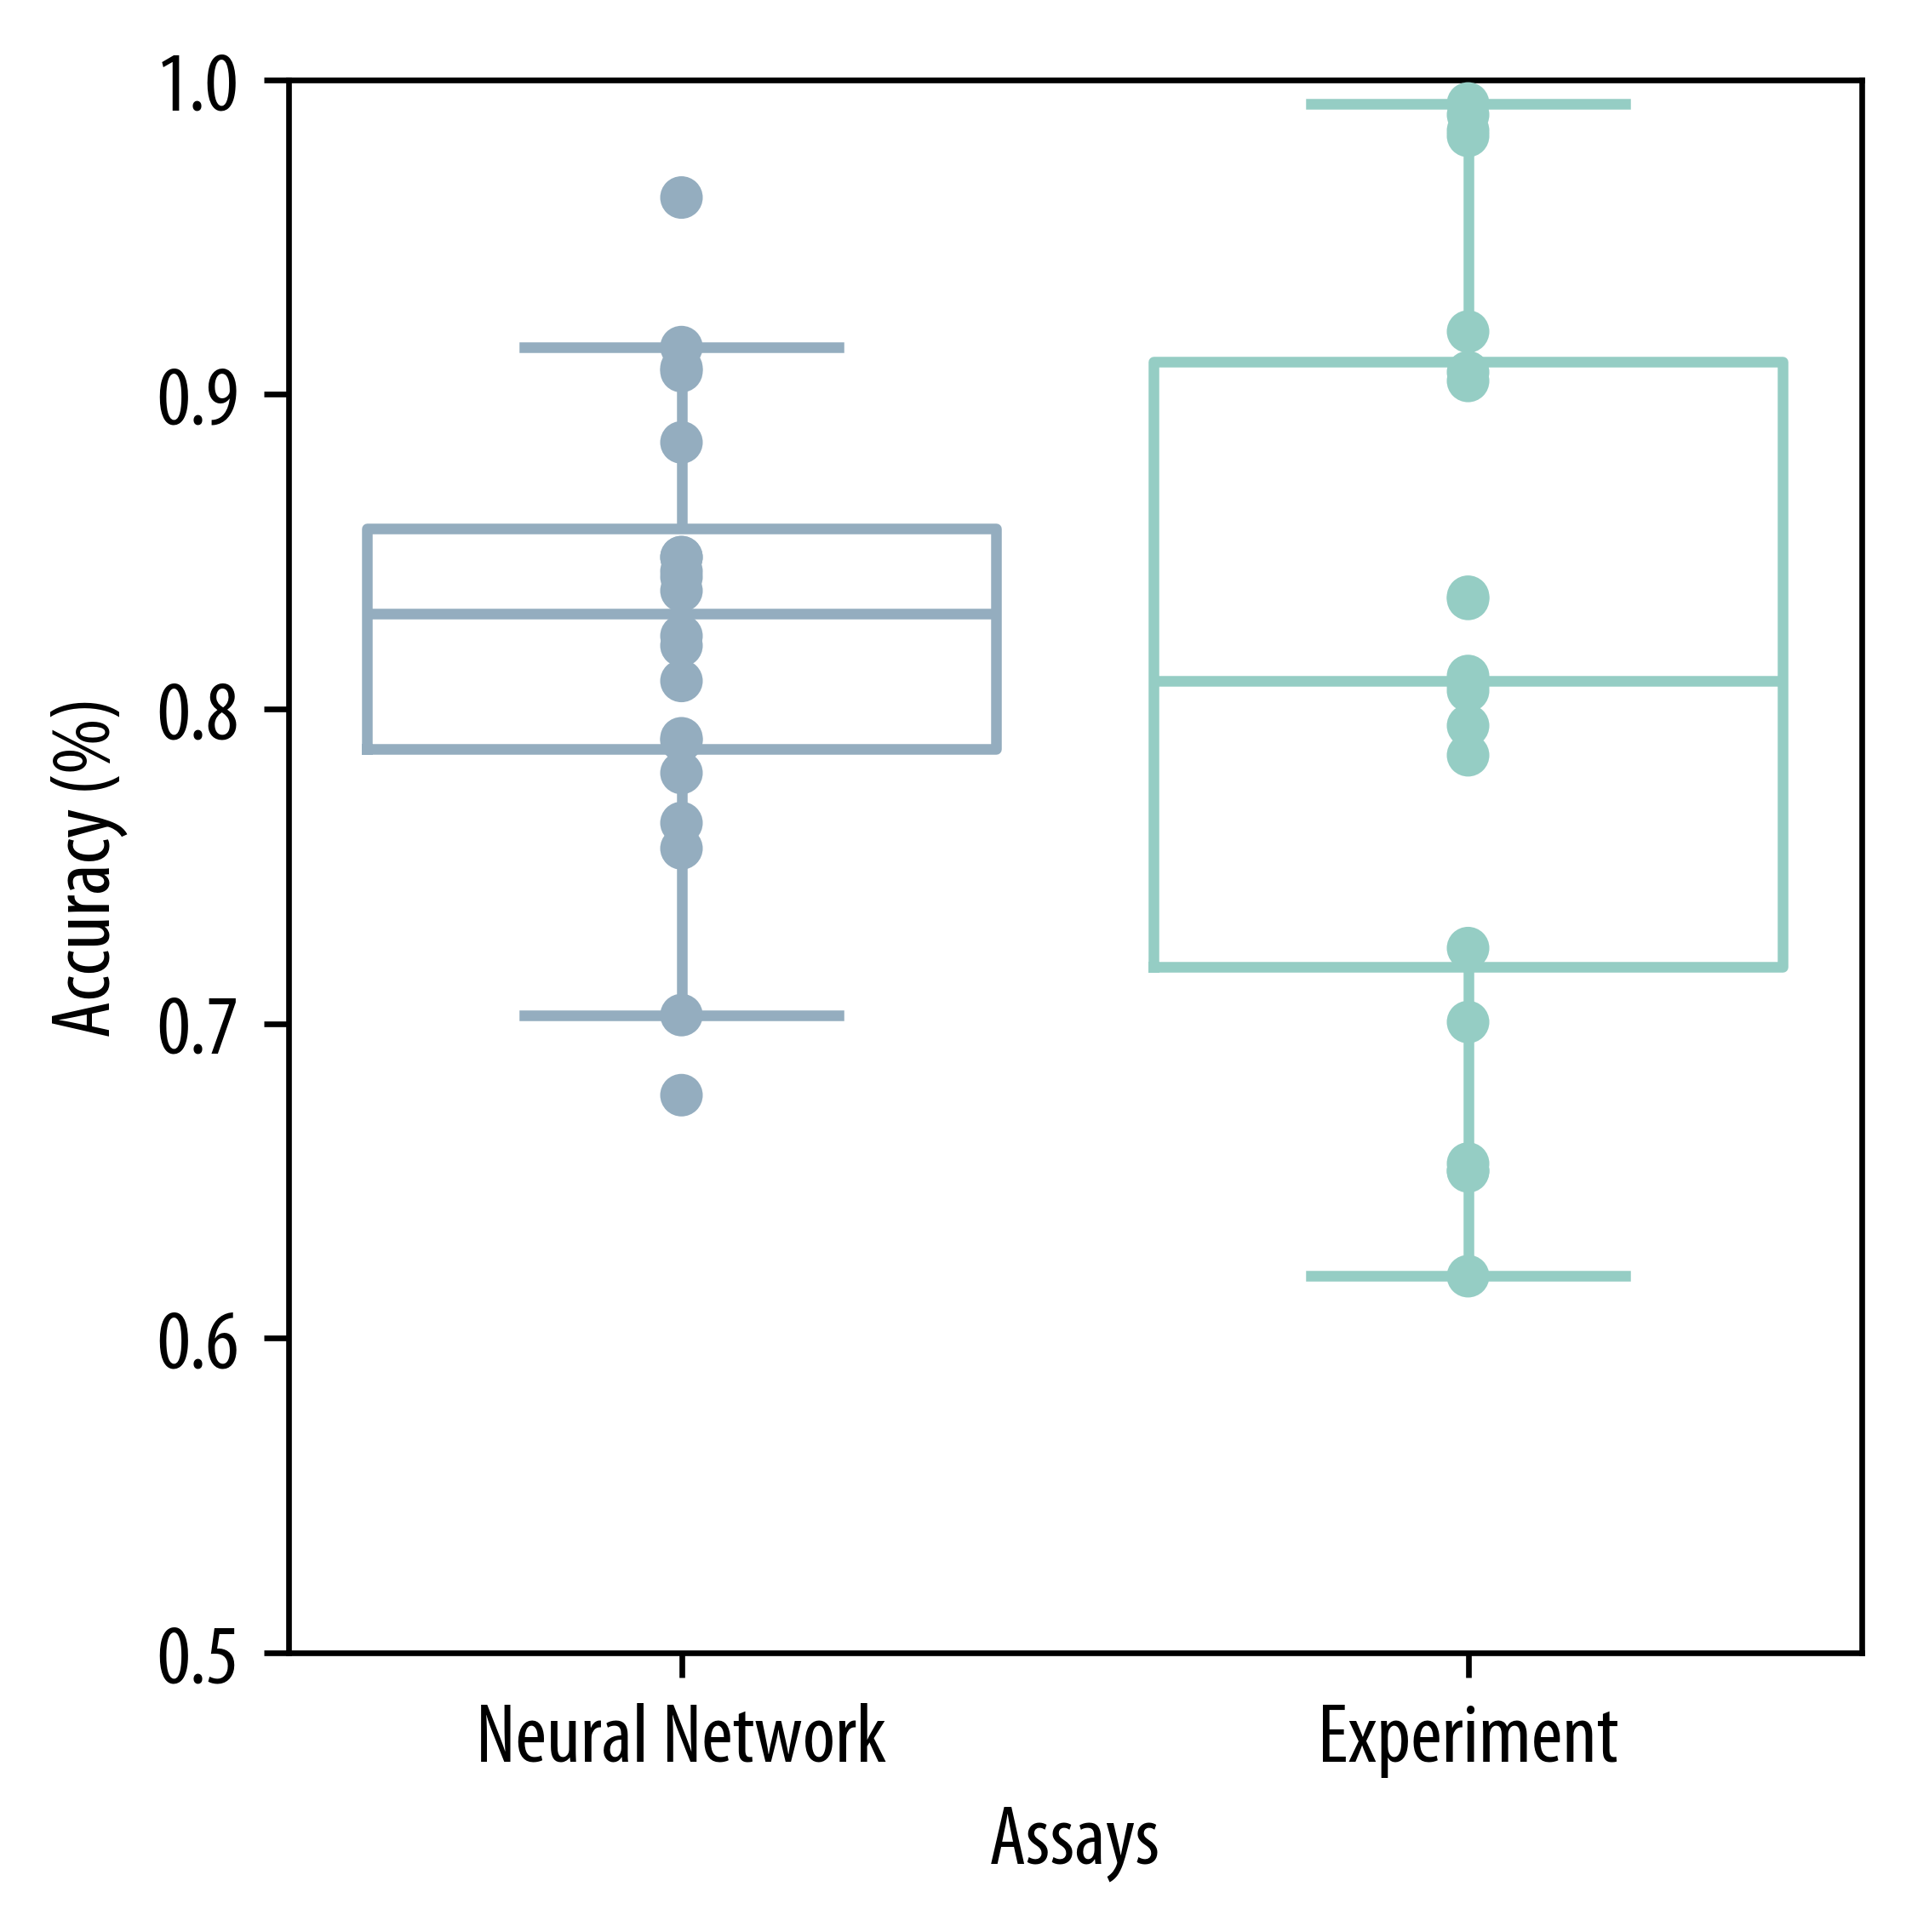 Przewidywania modelu a zgodność wyników eksperymentów
Sieć neuronowa (Neural Network)
Trafność przewidywań modelu oceniona względem wyniku testu referencyjnego.
Eksperyment (Experiment)
Zgodność wyników dwóch testów eksperymentalnych dotyczących tego samego celu lub efektu biologicznego.
Co wynika z tego porównania
W tym historycznym zestawieniu trafność przewidywań modelu i zgodność wyników eksperymentów mieszczą się w zbliżonym zakresie. Nie oznacza to równoważności dla wszystkich celów i warunków badania. Model pomaga wybrać związki do dalszych prac, ale ich działanie nadal trzeba sprawdzić eksperymentalnie.